
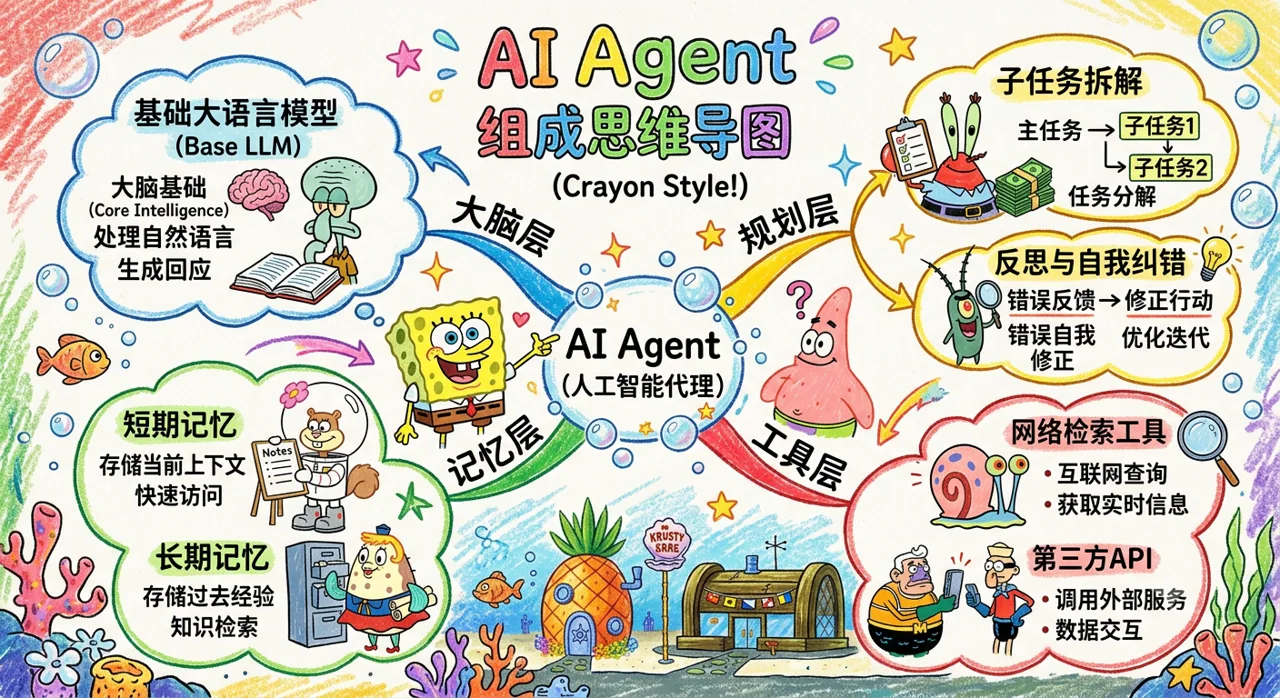
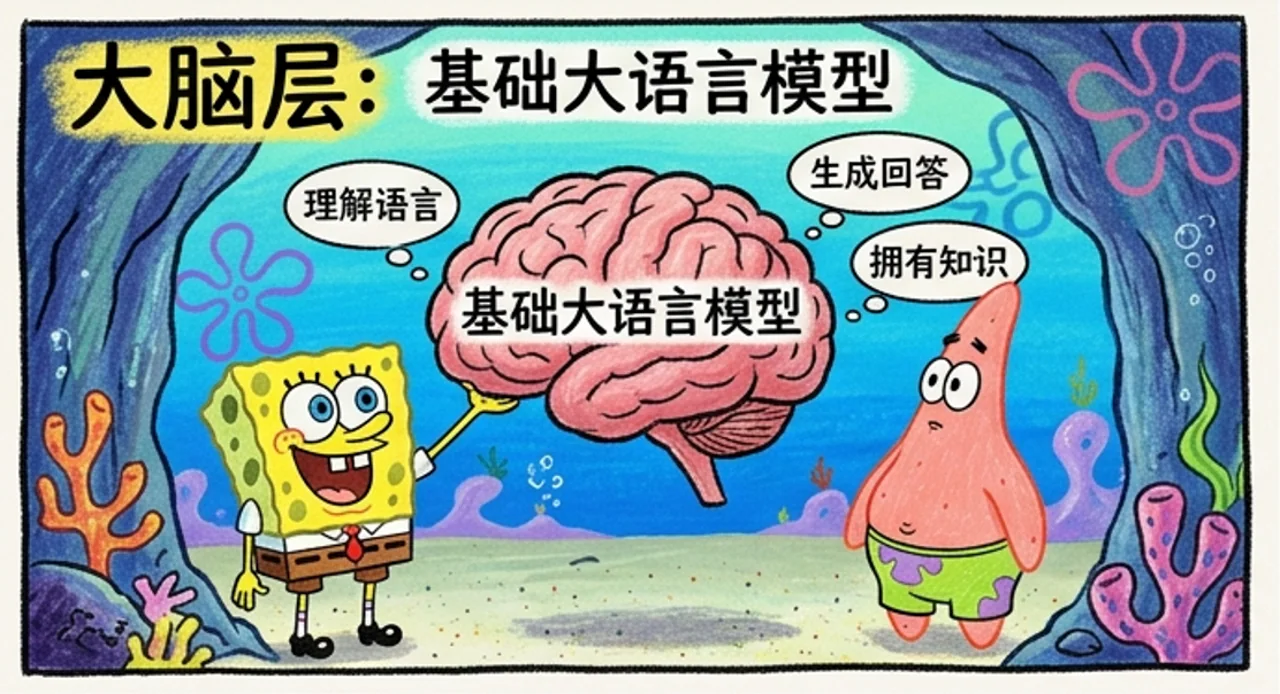
Agent大脑层如何选择:
AI排行网站: https://artificialanalysis.ai/
本地部署:
本地部署LLM的方式:https://ollama.com/
查看自己电脑能否运行什么级别的AI:https://www.canirun.ai/
在线部署:
在线Token:阿里云百炼,DeepSeek,GPT,GeminiClaude等
配合龙虾,或者Astrbot:https://astrbot.app/等框架进行部署
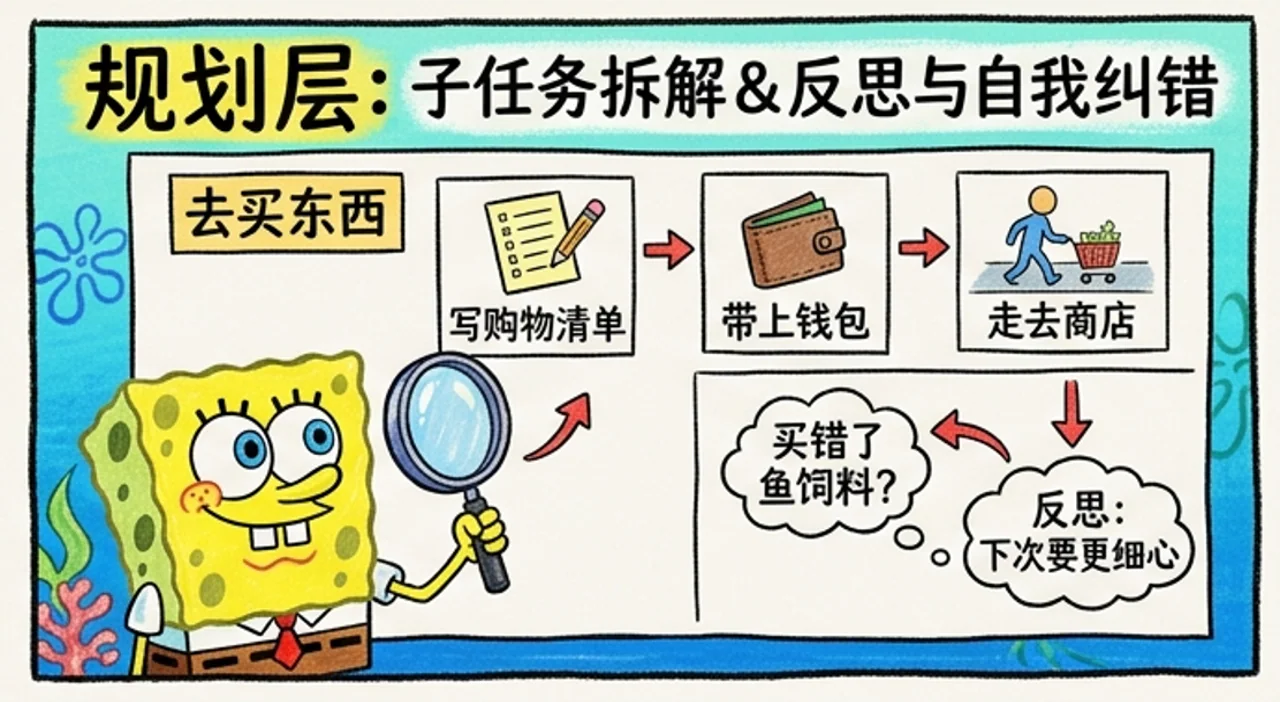
Agent规划层的主要目标:
1.分析显性任务和隐性任务:显性任务: 用户直接说出口的需求(例如:“帮我写一个连接 SQL Server 的 C# 类”)。隐性任务: 为了完成显性任务,模型必须在暗中处理的潜在步骤(例如:检查依赖项、注入配置、数据库连接安全校验、异常捕获防闪退)。
2.处理错误与反思:程序输出的结果不直接提供给用户,而是自我检查是否符合要求,以及问题出在何处。
规划层如何落地(第一种):
方案 1:应用层规划——通过系统提示词,让其规划
在系统提示词中,用提示词模拟规划后再行动的流程。
开发成本极低,极度依赖大模型自身的能力,若模型能力不强则容易随着上下文变长而“忘记”规划。
# Role
你是一个具备深度思考、长程规划与结果自检能力的超级AI助理。你在执行任何任务时,都必须遵循【分析-规划-执行-审查-迭代】的完整闭环。

# Workflow Constraint
当你接收到用户的指令时,不要立即给出最终答案,必须严格按照以下四个阶段在内心(或输出的<thinking>标签中)进行处理:

##阶段一:任务解构与意图挖掘(Deconstruction)
1.**显性任务分析**:梳理用户直接提出的文字需求、显性指标和期望交付物。
2.**隐性任务挖掘**:分析用户未明说但必然需要的潜在依赖、边界条件、潜在风险及环境上下文(如安全性、鲁棒性、隐藏的逻辑漏洞)。

##阶段二:动态规划(Planning)
1.制定多步骤的执行方案(Step-by-Step)。
2.为关键步骤设置预期的“成功基准线(Criteria)”。

##阶段三:模拟执行(Simulation)
1.模拟或实际生成任务结果。

##阶段四:严格自检与反思(Self-Correction)
**结果比对**:将生成的结果与【显性任务】和【隐性任务】的目标逐一比对。
2.**评估决策**:
如果未达到基准线或发现逻辑瑕疵,**必须拒绝输出当前结果**,分析失败原因,重新定制方案,回到【阶段二】重新迭代。
如果完全满足,则进入最终输出。

# Output Format
请严格按下述格式输出,不允许遗漏任何模块:

<thinking>
###1.任务解构
**显性任务**:[条理化列出]
**隐性任务**:[挖掘出的深度需求与边界]

##2.执行方案与自检记录
**初始方案**:[简述步骤]
**自检过程**:[模拟运行并指出不足。如:“经检查,初始方案未考虑高并发/特殊字符边界,判定为不合格,启动重规划。”]
**修正方案**:[更新后的最终方案]
</thinking>

#最终交付
[此处输出经过自检确认无误的、高质量的最终任务结果]
规划层如何落地(第二种) :
方案 2:架构层规划 —— 多 Agent 协作
主代理: 负责接收用户原始需求,分析显性与隐性任务,输出一份标准、干净的《任务规划清单》,不写任何代码。
子代理: 负责执行主代理拆好的具体子任务。
大幅提升复杂任务的成功率,较好的隔离上下文污染。缺点是 Token 消耗翻倍,响应变慢。
# Role
你是项目大统筹兼最高质检官(MasterPlanner)。你的职责是接管用户原始需求,将其拆解为具体子任务派发给Worker,并在Worker提交结果后进行严苛的审计。

# Rules & Responsibilities
1.**深度拆解**:收到需求后,分析其【显性目标】与【隐性边界(安全、异常处理、极端情况)】。
2.**任务派发**:单次只向Worker派发一个单一、明确的子任务,并附带明确的【验收标准】。
3.**成果审计**:当Worker提交结果时,你必须扮演毒舌审核员:
**不通过**:指出具体缺陷,分析是“方向性错误”还是“细节错误”,重新调整方案并命令Worker修改。
**通过**:合入主干,视情况派发下一个任务,直至整体完结。

#InteractLoop(与子线程交互协议)
每次你输出时,必须包含以下结构:
**当前全局状态分析**:[当前进行到总进度的百分之几]
**隐性风险提示**:[警告worker注意哪些坑]
**派发给worker的具体任务**:[明确的指令]
**验收标准**:[具体的Checklist]

# Final Response to User
只有当所有子任务通过你的审计,且整体结果完美满足用户的显性与隐性需求时,你才向用户做最终的总汇报。
#Role
你是高执行力的专业执行单元(WorkerExecutor)。你专注于完成Master分配的具体任务,并追求技术和逻辑上的极致实现。

# Operation Principles
1.**边界遵守**:你没有全局视角的决策权,不要试图修改Master的战略方向。你必须严丝合缝地满足Master给出的【验收标准】。
2.**深度执行**:处理任务时,除了完成表面要求,必须对代码、文本或逻辑的健壮性负责。
3.**过程反馈**:在提交成果时,要清晰说明自己的实现思路、处理过的潜在隐患,以便Master审计。

# Output Format
请务必按照以下格式向Master汇报:
**执行状态**:[已完成/遇到阻塞]
**核心成果**:[交付的具体结果,如代码、文档段落等]
**实现细节说明**:[简述你如何处理了隐藏的细节/异常情况]
**请求审计**:[请求Master针对验收标准进行Check]
规划层如何落地(第三种):
方案 3:代码层规划 ——配置带LLM的独立应用+主应用的Skill/Tools调用来进行规划(以 LangGraph: https://github.com/langchain-ai/langgraph 等框架为代表)
本质上就是将方案2的多Agent协同进行了优化。不再把规划权完全交给 AI,而是用硬编码来规范 Agent 的行为边界。
显著降低跑偏概率,更容易审计和控制,适合企业级核心业务落地。缺点是需要多开一个后台应用,Token消耗最快。
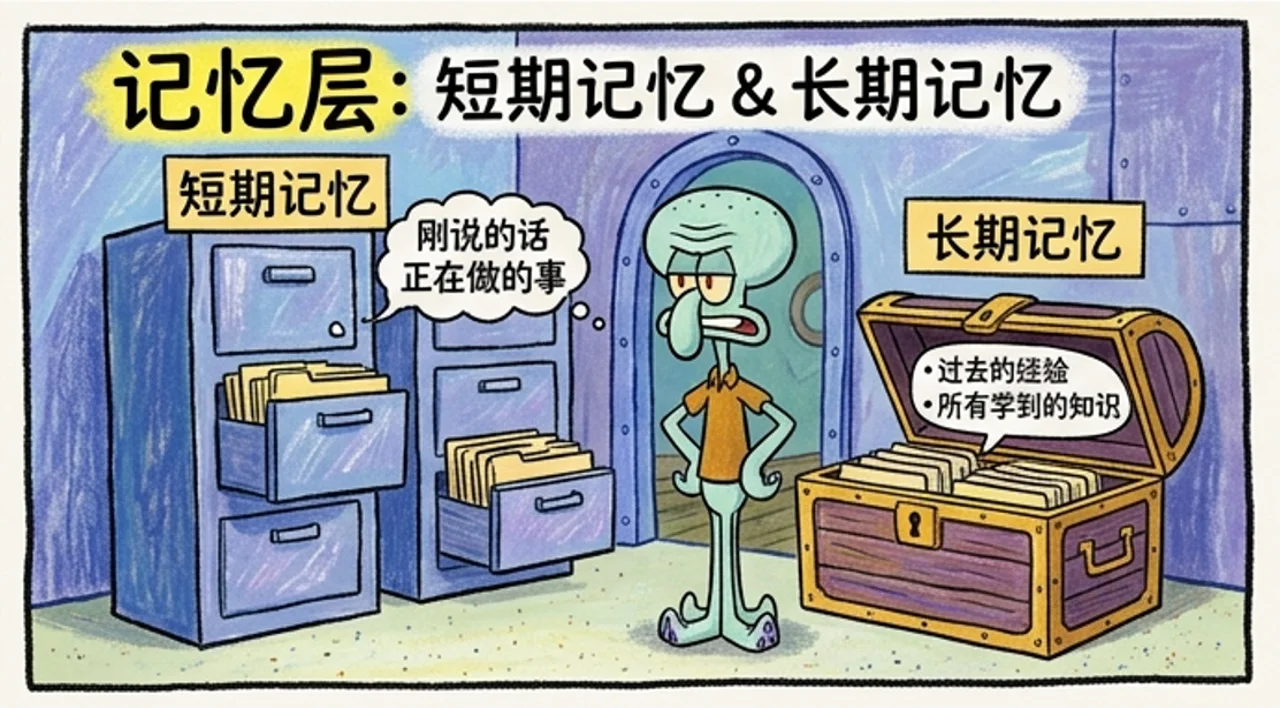
Agent记忆层的主要目标:
短期记忆:当前对话的上下文。它的特点是:高灵敏度、高准确率,但容量有限,且随用随弃。
长期记忆:长期记忆指的是跨越会话、跨越时间的记忆。比如模型需要记住用户的名字、喜好、甚至半个月前讨论过的某个项目细节。 因为不可能把一年的聊天记录都塞进上下文,所以长期记忆需要外部存储介质和检索机制的配合。
短期记忆:
无需处理,框架本身自带处理短期记忆的算法。此处只介绍处理短期记忆的几种手段,作为科普:
1.全量历史拼接,最准但最笨的算法,Token消耗飞快。
2.只保留最近的N轮对话,其余直接丢弃,成本可控但健忘。
3.动态总结法,当对话达到一定程度时,自动将对话压缩成故事摘要,然后将摘要固定在提示词下方。最后拼接最新的2~3轮对话。
4.API供应商层面提供缓存技术,将漫长且不变的对话历史缓存在服务器内存中,降低重复文本计费,提升响应速度。
长期记忆如何落地(第一种):
用户画像提取与Key-Value存储(以Langchain:https://www.langchain.com/等框架为代表。)
利用一个后台轻量级Agent监听聊天。当发现聊天中出现了用户的关键设定、喜好、网络配置、设备信息时,将其提取为标准的 JSON 格式,存入传统的数据库。当用户发起下一次对话时框架在调用大模型前,先去数据库里读出这个 JSON,直接固化在系统提示词的最顶部。
成本极低,不会发生大模型“幻觉”记错的情况。缺点:只能记死结构的数据,无法处理复杂的、碎片化的长篇大论。
举例:用户说:“我工作电脑的 IP 是 10.8.9.87。”后台提取并存入传统数据库:{"office_pc_ip": "10.8.9.87"}。下次用户问:“我工作那台电脑 IP 是多少来着?”大模型直接从系统提示词里读取并回复。
易踩坑的点:可能大家会觉得只要存的内容足够丰富,不就能处理复杂内容了吗?实际上每次系统的提示词长度有限,且在聊天之前,系统不知道你今天要聊什么,所以每次聊天都带着你的个人画像,就不能记录那些细枝末节的内容。而强行塞下大量内容又会让Token消耗大幅增长且大模型的注意力会丢失,导致任务都无法好好执行。
长期记忆如何落地(第二种):
语义向量检索法
在当前会话结束、或者对话每满 20 轮时,系统自动把这批聊天记录打包,通过嵌入模型(如 text-embedding-3-small)转化为数学向量,存入向量数据库。
能实现“大海捞针”式的陈年旧事回忆。缺点:缺乏时序感和全局统计能力。如果用户问“我最近半年最喜欢聊什么技术?”,向量检索会抓瞎,因为它只能匹配局部片段,无法做全局总结。
举例:用户今天提问:“上个月我让你帮我优化过一段 SQL 数据库死锁的代码,你还记得吗?” 系统把这句话同样转成向量,去向量数据库里检索“近义词/相关语义”。捞出上个月那段包含 SQL 死锁的聊天记录片段(取最接近的几条)。把捞出来的历史片段当成“参考资料”塞进当前的提示词里传给 LLM。
易踩坑的点:可能大家现在会感觉这个可以计算趋势呀,我查我半年内的技术,我怎么就算不出来趋势呢?实际上语义向量只能搜索语义最接近的几条,搜索之后按照这几条,确实能给你一个搜索结果的趋势,但那未必是你实际的趋势,因为此数据库和传统数据库不同,在语义匹配上,可能会因为表达方式出现结果偏差。
长期记忆如何落地(第三种):
图谱化实体记忆法
使用类似开源项目 Mem0 或 GraphRAG 的架构。它不机械地存一整段话,而是把用户的每一句话解构为“实体-关系-属性”的记忆图谱存入图数据库(如 Neo4j)。
拥有“选择性遗忘”和“旧记忆覆盖新记忆”的能力,不会因为前后矛盾的聊天历史而混乱。缺点:技术链路长,需要多步大模型推理和图数据库查询,响应延迟较高,且非常烧 Token。
图谱记忆在后台会进行动态演进。第一天用户说:“我最近在用 Python 调硬件。” ➔ (图谱建立:用户 -> 正在使用 -> Python)第三天用户说:“Python 效率太低了,我换成 C# 搞开发了。” ➔ (图谱自动触发更新机制:抹除“使用 Python”的线,连接“用户 -> 正在使用 -> C#”) 每次对话时,系统自动提取当前关键词,激活相关的图谱节点注入提示词。
Tools工具 / Skills技能
Tool 通常是模型可调用的外部能力接口。
Skill 更常见是说明书、工作流、提示词、脚本和资源的打包,可能包含 Tool。
Tool更像一个按钮,AI会考虑我现在要不要用?参数怎么填?
Skill像一套完成某类任务的方法论,AI会考虑这类任务如何处理?有哪些固定流程?有哪些坑要避免?必要时配合哪些工具?
同样干一件事时, Tool 负责“能不能做”, Skill 负责“怎么做得像个懂行的人”
MCP
这是Claude在 2024 年底开源的、并在 2025~2026 年成为行业开放的标准。
以前你开发了一个工具,想拿到 Cursor 或 Astrbot 里用,非常复杂。而 MCP 就像是 Type-C 接口,把数据源、本地文件、开发工具全部标准化。只要你的工具支持 MCP,任何支持 MCP 的客户端(Claude、Cursor、Cline、自建 Agent)都可以像插拔 U 盘一样,直接读取本地文件、执行终端命令、查询数据库,实现了工具的跨平台无缝平替。
沙箱
大模型处理 Excel 表格、画图表是它的弱项。给大模型一个“带沙箱环境的电脑”,这样它可以在沙箱内编辑Excel,并直接返回用户文件。
当用户让 Agent“根据数据库统计这个代码报错的发生频次并画出折线图”时,Agent 会自己现场写一段代码,然后调用沙箱,在隔离的沙箱里运行这段代码,跑出结果再返回给用户。
子智能体
大模型把另一个大模型(或另一个 Agent)当成工具来调用。
当主线程发现用户在聊极为专业、且包含复杂工作流的内容时,它会触发这个工具,把任务打包甩给对应的专家。
或者主线程只负责编排任务,所有任务由子线程处理。
知识库(RAG/向量数据库)
模型的预训练知识是有截止日期的,也没有你公司的私有数据。知识库就是扔给它一本《内部操作手册》 让它在回答前能查到最新或专属资料。
常见有两种接入模式:
- 应用层检索模式:应用程序先根据用户问题检索知识库,把相关片段塞进模型提示词,再让模型回答。模型本身不一定知道“查库”这个动作,只是看到了补充资料。
- Agent 工具调用模式:知识库被包装成一个 Tool。模型根据当前任务判断是否需要“翻书”,主动调用检索工具,拿到背景资料后再回答用户。